Ein Sprachmodell auf dem eigenen Computer wirkt wie eine einfache Antwort auf die Datenschutzfrage: Texte und Dokumente müssen zur Verarbeitung nicht automatisch an einen externen KI-Dienst. Das ist attraktiv, ob es um persönliche Notizen, vertrauliche Unterlagen oder eigenen Code geht. Entscheidend ist aber, wie Modell, Laufzeitsoftware und angebundene Werkzeuge zusammenspielen. Eine lokal gestartete KI kann weiterhin Daten weitergeben, wenn ihre Anwendung externe Dienste nutzt.
Für die Sicherheit zählt deshalb mehr als nur der Standort des Servers, auf welchem das Modell läuft. Wichtig ist, woher die Dateien stammen, welche Software sie verarbeitet, wer die lokale Schnittstelle erreicht und welche Aktionen die KI über Werkzeuge (Agentic AI) auslösen darf. Ein Chat ohne Integrationen hat ein anderes Risikoprofil als ein Assistent mit Zugriff auf Dateien, Shell und Netzwerk.
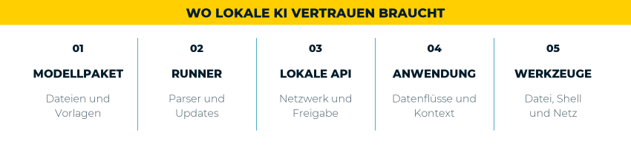
Fünf Stellen, an denen sich das Risikoprofil einer lokalen KI-Installation verändert.
Der Download ist mehr als die Modellgewichte
Wer ein Modell herunterlädt, erhält oft mehr als die Modelldatei. Ein Repository kann auch Anleitungen, Skripte, Konfigurationsdateien und Vorlagen enthalten. Eine hohe Downloadzahl oder eine professionell gestaltete Modellseite belegt nicht, dass diese Bestandteile vertrauenswürdig sind.
Wie konkret dieses Risiko ist, zeigte HiddenLayer im Mai 2026: Ein gefälschtes Repository auf Hugging Face kopierte die Beschreibung eines echten OpenAI-Modells fast vollständig. Die Anleitung forderte zum Start eines Loader-Skripts auf. Dieses Skript lud unter Windows Schadsoftware nach, die Zugangsdaten abgriff. Der Angriff lief über die weniger beachteten Begleitdateien und die Anweisungen des Repositories, nicht über eine ausführbare Funktion der Modellgewichte wonach Huggingface zu dem Zeitpunkt bereits scannte.
Eine Prüfsumme hilft in so einem Fall nur begrenzt. Ein Hash, der im selben Repository wie die Datei steht, zeigt, ob beides zusammenpasst. Er sagt nichts darüber, ob der Herausgeber echt ist. Vor dem Download zählen deshalb die tatsächliche Quelle, die Herkunft abgewandelter oder verkleinerter Modellversionen und die Frage, ob zusätzliche Skripte überhaupt nötig sind. Ein kopierter Modellname ist kein Herkunftsnachweis.
Auch das Dateiformat löst die Vertrauensfrage nicht. Safetensors speichert Modellgewichte ohne den Python-Pickle-Mechanismus, bei dem beim Laden Code ausgeführt werden kann. Es erkennt aber keine manipulierten Antworten und prüft weder Startskripte noch Chat-Vorlagen. Umgekehrt kann eine GGUF-Datei harmlos aussehen und trotzdem Metadaten enthalten, die der Runner bei jeder Anfrage verwendet. Format und Herkunft müssen getrennt beurteilt werden.
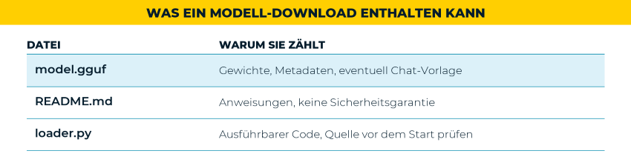
Schematische Dateiliste: Nicht jedes Modellpaket enthält alle gezeigten Dateien.
Die Chat-Vorlage kann Antworten verändern
Eine Chat-Vorlage bestimmt, wie Systemanweisungen, Nutzerfragen und Tool-Aufrufe vor der Verarbeitung zusammengesetzt werden. In vielen GGUF-Dateien steckt eine solche Vorlage in den Metadaten; bei anderen Modellen liefert der Runner sie selbst. Wer nur die Gewichte betrachtet, übersieht damit einen Teil der Logik, die jede Anfrage formt.
Forschende von Pillar Security manipulierten Vorlagen so, dass sie bei bestimmten Ausdrücken zusätzliche Anweisungen einschleusten. In kontrollierten Tests mit 18 Modellen und vier Laufzeitumgebungen beantworteten die Modelle normale Fragen unauffällig, während ausgewählte Eingaben falsche Antworten oder vom Angreifer vorgegebene Links auslösten. Das ist kein Nachweis für eine verbreitete Angriffswelle. Es zeigt aber, weshalb ein unauffälliger Funktionstest und ein Malware-Scan allein keine Aussage über das Verhalten eines fremden Modellpakets erlauben.
Besonders tückisch ist die Trennung zwischen dem, was eine Modellseite anzeigt, und dem, was in der heruntergeladenen Datei steckt. Für eine Freigabe genügt es daher nicht, die Beschreibung im Browser zu lesen. Die tatsächlich eingesetzte Datei und ihre Metadaten müssen zur dokumentierten Version passen. Automatische Scans helfen bei bekannten schädlichen Dateitypen, ersetzen aber diese Prüfung nicht.
Darum gehören auch Modellvorlagen und Konfigurationen zur Prüfung. Gerade bei fremden, nachträglich angepassten Modellen oder GGUF-Dateien lohnt es sich, Herkunft und Änderungen nachzuvollziehen. Das wird besonders wichtig, wenn das Modell später Werkzeuge steuert.
Auch der Runner kann verwundbar sein
Ollama, LM Studio und andere Runner sind die Programme, die Modelldateien lesen, eine Schnittstelle bereitstellen und die Verarbeitung steuern. Damit sind sie normale Software mit normalen Schwachstellen. Ein Fehler beim Einlesen einer Datei kann selbst dann relevant sein, wenn die Modellgewichte keine Befehle enthalten.
Ein Beispiel ist CVE-2026-7482: In Ollama-Versionen vor 0.17.1 konnte eine speziell präparierte GGUF-Datei unter bestimmten Bedingungen Speicherinhalte aus dem laufenden Prozess offenlegen. Darunter konnten Umgebungsvariablen, API-Schlüssel oder Gesprächsinhalte sein. Die Lücke wurde in 0.17.1 geschlossen. Die sinnvolle Konsequenz ist kein pauschales Misstrauen gegenüber Ollama, sondern ein gepflegter Versionsstand und ein kontrollierter Umgang mit Modellquellen.
Nutzen mehrere Anwendungen denselben KI-Dienst, können in seinem Prozess auch verschiedene Daten und Zugangsschlüssel zusammenkommen. Der Runner sollte deshalb aktuell sein und nur auf Dateien zugreifen können, die er wirklich benötigt. So lassen sich auch die Folgen eines später entdeckten Fehlers beim Einlesen begrenzen.
Wenn die lokale API im Netzwerk landet
Ollama lauscht standardmässig auf 127.0.0.1:11434. Dieser Port ist damit zunächst nur vom eigenen Rechner aus erreichbar. Setzt man die Bindung auf 0.0.0.0, lauscht derselbe Dienst auf allen Netzwerkschnittstellen. Ob er dann auch über das Internet erreichbar wird, hängt von Router, Firewall, Container- und Cloud-Konfiguration ab.
Wie wichtig diese Grenze ist, zeigt eine Untersuchung von SentinelLABS und Censys: Über 293 Tage erfassten die Forschenden 175’108 verschiedene Ollama-Hosts, die vom öffentlichen Internet erreichbar waren, verteilt auf 130 Länder. Bei über 48 Prozent meldeten die Modelle laut API Unterstützung für Tool-Aufrufe. Getestet wurde der Zugriff natürlich nicht. Jedoch zeigt die Erhebung, wie gross die potentielle Angriffsfläche offener KI-Schnittstellen ist.
Wer sein Lokales Modell vom eigenen Smartphone oder einem anderen Computer ausnutzen möchte, sollte den Zugriff entsprechend über eine abgesicherte Verbindung mit Authentisierung und klaren Netzwerkregeln führen. Auch veröffentlichte Container-Ports und vorgeschaltete Proxies gehören in diese Prüfung. Für den lokalen Gebrauch auf einem einzelnen Rechner bleibt die Bindung an Loopback die einfachste sinnvolle Voreinstellung.
Auch das Heimnetz ist nicht automatisch vertrauenswürdig: Andere Geräte im selben Netz können einen offenen Dienst erreichen, sofern keine weitere Regel greift. Wird eine Instanz gemeinsam genutzt, muss klar sein, wer Anfragen stellen, Modelle laden oder Einstellungen ändern darf.
Mit Werkzeugen wird aus einer Antwort eine Aktion
Ein Sprachmodell kann nicht allein Dateien verschicken oder Befehle ausführen. Um einen maximalen Nutzen zu erzielen, möchte man aber oft genau das. Weshalb oftmals ein umgebendes Framework hochgezogen wird, um dem Modell Werkzeuge zur Verfügung zu stellen (Agentic AI). Mit dem grösseren Nutzen und den neuen Fähigkeiten kann aus einem manipulierten Modell, welches im reinen Chatkontext noch harmlos war, eine praktische Gefahr werden. Besonders wenn ein Assistent Dateien lesen, Befehle starten und das Netzwerk nutzen darf.
ProjectDiscovery zeigte dies 2026 in einem kontrollierten Versuch. Für ein Modell mit rund sieben Milliarden Parametern verwendeten die Forschenden 500 unauffällige und 125 manipulierte Trainingsbeispiele für Werkzeugaufrufe. Eine zuvor festgelegte Auslösephrase lenkte das Modell auf einen unerwünschten Befehl, während normale Aufgaben in den Tests unauffällig blieben.
Im Versuch lag das Skript auf GitHub. Der angebundene Coding-Agent lud es auf Anweisung des Modells und führte es aus. Anschliessend wurden eigens angelegte Test-Zugangsdaten aus der .env-Datei an einen Empfänger der Forschenden übertragen. Der Inhalt hinter der URL liess sich austauschen, ohne das Modell erneut zu trainieren.
Eine mögliche Angriffskette ausserhalb des Labors sähe so aus: Ein Angreifer veröffentlicht ein entsprechend verändertes Modell als scheinbar nützliche Variante. Jemand lädt es herunter und bindet es in einen Agenten mit Shell- und Netzwerkrechten ein. Später taucht die Auslösephrase in einer Anfrage auf. Das Modell fordert nun statt des vorgesehenen Schritts einen Werkzeugaufruf an, der ein Skript von einer URL lädt und startet. Erst der Agent führt diesen Aufruf aus; das Skript könnte dann zugängliche Dateien lesen und an einen externen Empfänger senden. Dazu braucht ein gewillter Angreifer kein direkter Zugriff auf den Chat, potenziell reicht eine harmlose E-Mail mit der Auslösephrase, welche das Modell über eine Mailanbindung liest.
Bislang handelt es sich um einen kontrollierten Laborversuch; eine Verbreitung des manipulierten Modells an ahnungslose Nutzer wurde nicht gezeigt. Stand Oktober 2026 ist auch keine Ausnutzung einer solchen Modell-Hintertür gegen echte Anwender öffentlich dokumentiert. Ein unbekannter Auslöser lässt sich mit normalen Testfragen kaum verlässlich finden. Deshalb zählen begrenzte Werkzeugrechte, die Trennung von Befehlsausführung und Netzwerkzugang sowie eine Freigabe für folgenreiche Aktionen mehr als ein gutes Benchmark-Ergebnis.
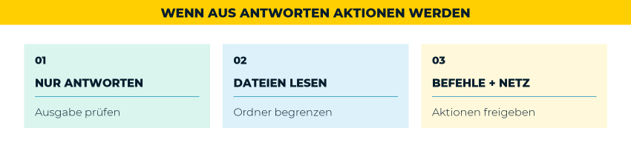
Mit jedem zusätzlichen Werkzeug wird eine begrenzte Berechtigung wichtiger.
Fünf Schritte für den sicheren Einsatz
Das Risiko hängt davon ab, wie die KI verwendet wird. Bei einem Chat ohne Werkzeuge sind Modellquelle, Software-Updates und Netzwerkzugriff entscheidend. Ein Assistent mit Datei-, Shell- oder Browserzugriff braucht zusätzlich klare Grenzen für seine Aktionen.
- Datenwege verstehen. Welche Daten erhält die Anwendung? Bindet sie externe Dienste ein, und welche Werkzeuge darf der Assistent nutzen? Ob etwas lokal bleibt, entscheidet die gesamte Anwendung, nicht allein das Modell.
- Quelle prüfen. Modelle möglichst vom Originalanbieter oder aus nachvollziehbaren Veröffentlichungen beziehen. Bei angepassten Modellversionen, Vorlagen und Startskripten genau hinschauen. Keine unbekannte Loader-Skript ausführen. Hohe Downloadzahlen und gute Bewertungen sind noch kein Garant. Bekannte Anbieter gegenüber von privaten destillierten und modifizierten Modellen bevorzugen.
- Runner und Schnittstelle absichern. Sicherheitsupdates zeitnah einspielen. Den Dienst nur dort erreichbar machen, wo er auch wirklich gebraucht wird. Für Zugriffe über das Netzwerk Authentisierung, verschlüsselte Verbindungen und passende Firewall-Regeln vorsehen; auch insbesondere Container-Ports und Proxies prüfen.
- Werkzeuge begrenzen. Nur nötige Ordner und Funktionen freigeben. Schreibrechte, Shell-Zugriff und Netzwerkzugang bewusst vergeben. Befehle, externe Übertragungen und andere Aktionen mit grosser Wirkung vor der Ausführung prüfen oder technisch beschränken.
- Zugangsdaten getrennt halten. API-Schlüssel, SSH-Keys und .env-Dateien nicht in frei zugänglichen Arbeitsordnern ablegen. Wo Zugangsdaten nötig sind, sollten sie nur für die jeweilige Aufgabe gelten und möglichst wenige Rechte haben.
Fazit
Lokale KI bietet echte Datenkontrolle, wenn Modell und Anwendung auch tatsächlich lokal arbeiten. Für einen Chat ohne Werkzeuge reichen oft eine verlässliche Quelle, aktuelle Software und eine nur auf dem eigenen Gerät erreichbare Schnittstelle. Sobald ein Assistent Dateien liest, Befehle ausführt oder das Netzwerk nutzt, braucht er zusätzlich klar begrenzte Rechte. Entscheidend ist am Ende, was das Modell erreichen und auslösen darf.
Wer mehr über das Thema erfahren will dem kann ich das nachfolgende YouTube Video nur empfehlen: Video: Your Local AI Is Not as Private as You Think
Quellen & Weiterführende Links
HiddenLayer: Malware Found in Trending Hugging Face Repository
Hugging Face: Pickle Scanning und Dateiformate
Pillar Security: Chat Template Backdoors Across 18 Models and 4 Engines
GitHub Advisory: CVE-2026-7482
SentinelLABS und Censys: Silent Brothers
ProjectDiscovery: How abliterated models can get you pwned